你想降低采访者的声音,又不影响嘉宾音量;或剪掉一个问题,却不截断回答。但手里只有一份混合录音。
访谈说话人分离可以为每位说话人生成独立、时间对齐的 WAV 文件。 先试听采访者和嘉宾的声音,下载后再在编辑器中分别调整。下面的实际示例可以帮助你判断分离前后有什么变化。
同一条件下对比标准模式与高级模式
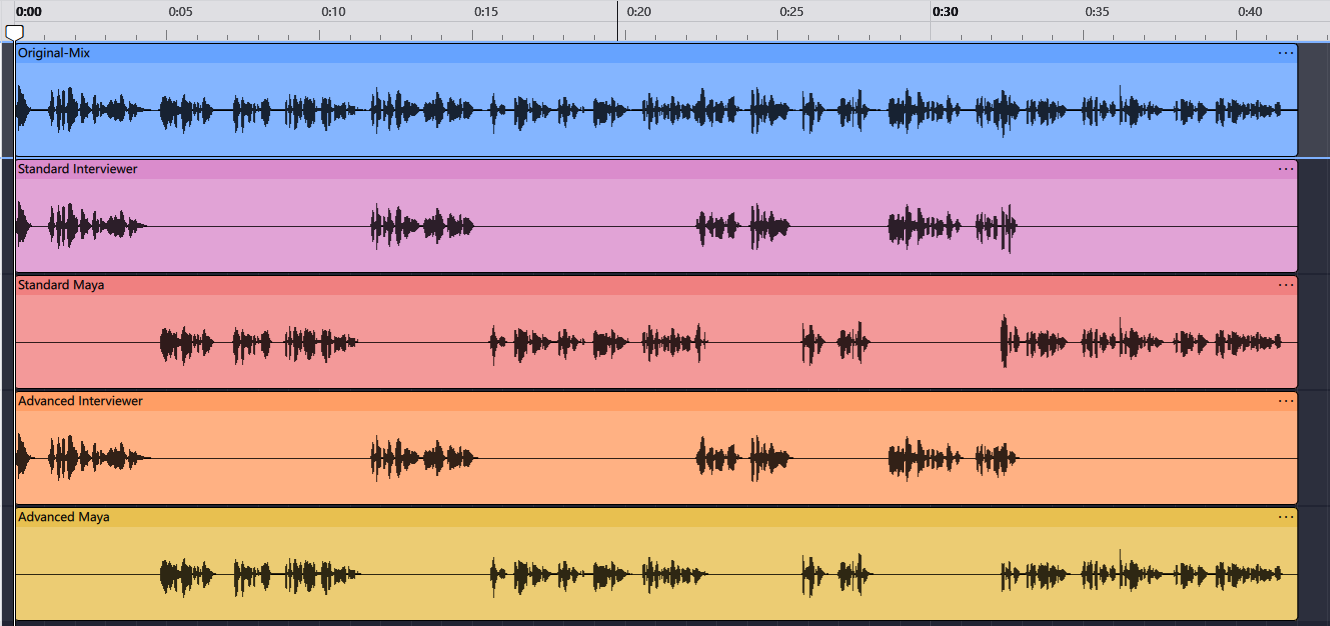
2026 年 9 月 6 日,Seply 编辑团队使用两种模式处理了同一份已获授权、长 42.031 秒的访谈混音。素材为原创英文对话,使用有授权的 TTS 配音,再在 Audacity 中混音;共有两位说话人,没有音乐,也没有额外加入环境噪声。
Seply 实际测试 · 2026 年 9 月 6 日
同一份录音,两种分离模式
切换音轨时保持播放位置,对比同一次插话在原音、标准模式和高级模式中的表现。
42.031 秒
两位合成英文说话人
- 已获授权的素材
- 原创双人 TTS 对话,在 Audacity 中混音,无音乐,也未添加环境噪声。
- 原始混音
- 立体声 MP3 · 44.1 kHz · 192 kbps
- 标准模式
- 指定 2 人 · 两条 16 位、44.1 kHz 单声道 WAV
- 高级模式
- 自动检测 · 两条 16 位、44.1 kHz 立体声 WAV
 查看原图
 查看原图
 查看原图
这些观察只描述一次 42 秒受控测试,不代表通用准确率。人物和文字已在多处与原始混音核对。
实测响度差异
原始混音中,采访者在 28.61–31.00 秒的发言约为 -17.5 LUFS,随后 Maya 在 32.95–41.46 秒的回答约为 -20.8 LUFS,轻了约 3.3 LU。上述综合响度通过 EBU R128 分析原始混音得到,只描述本段素材。
EBU R 128提供了此处引用的响度测量和归一化框架。LUFS 表示响度,不表示分离准确率;两段发言的响度差既不能衡量声音泄漏,也不能证明某种模式在所有录音上都更好。
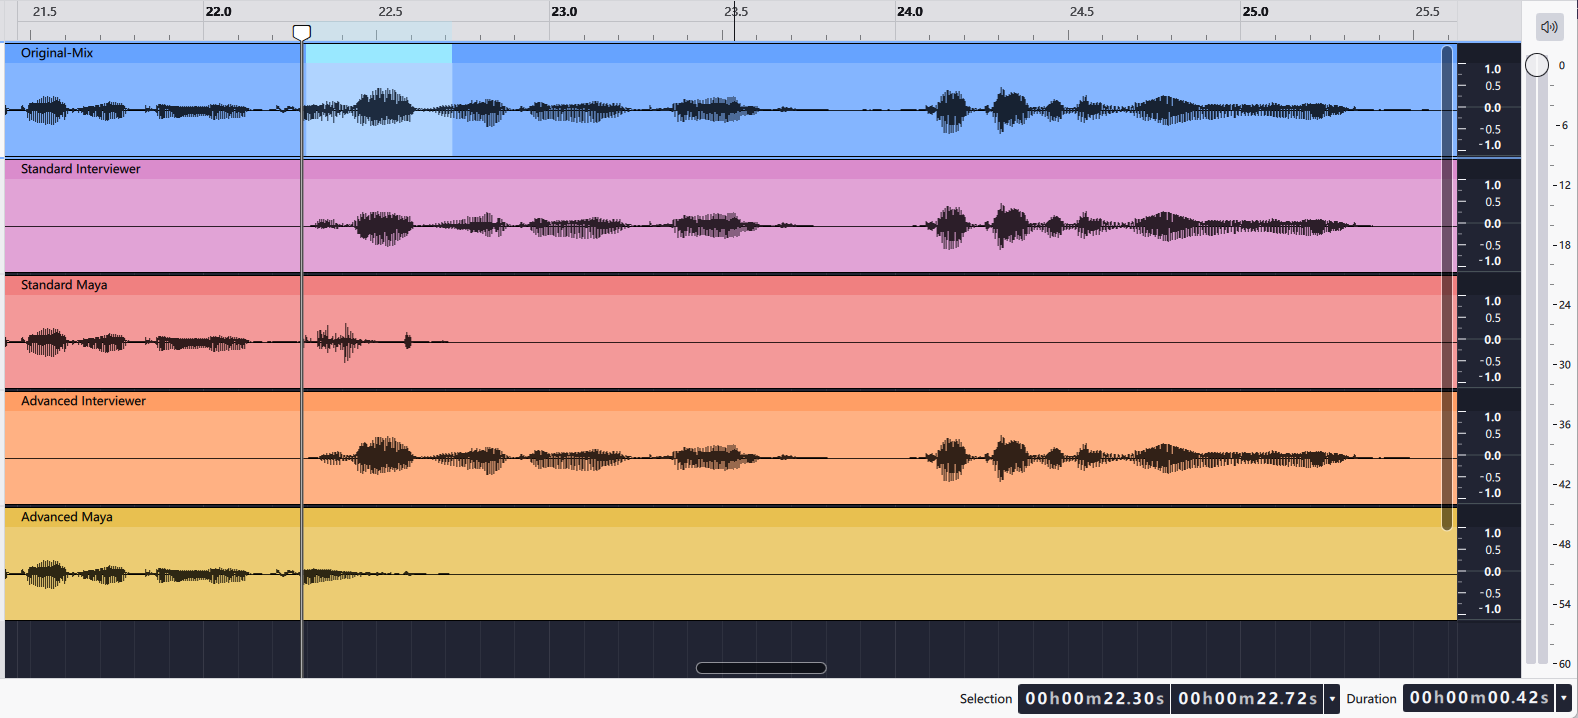
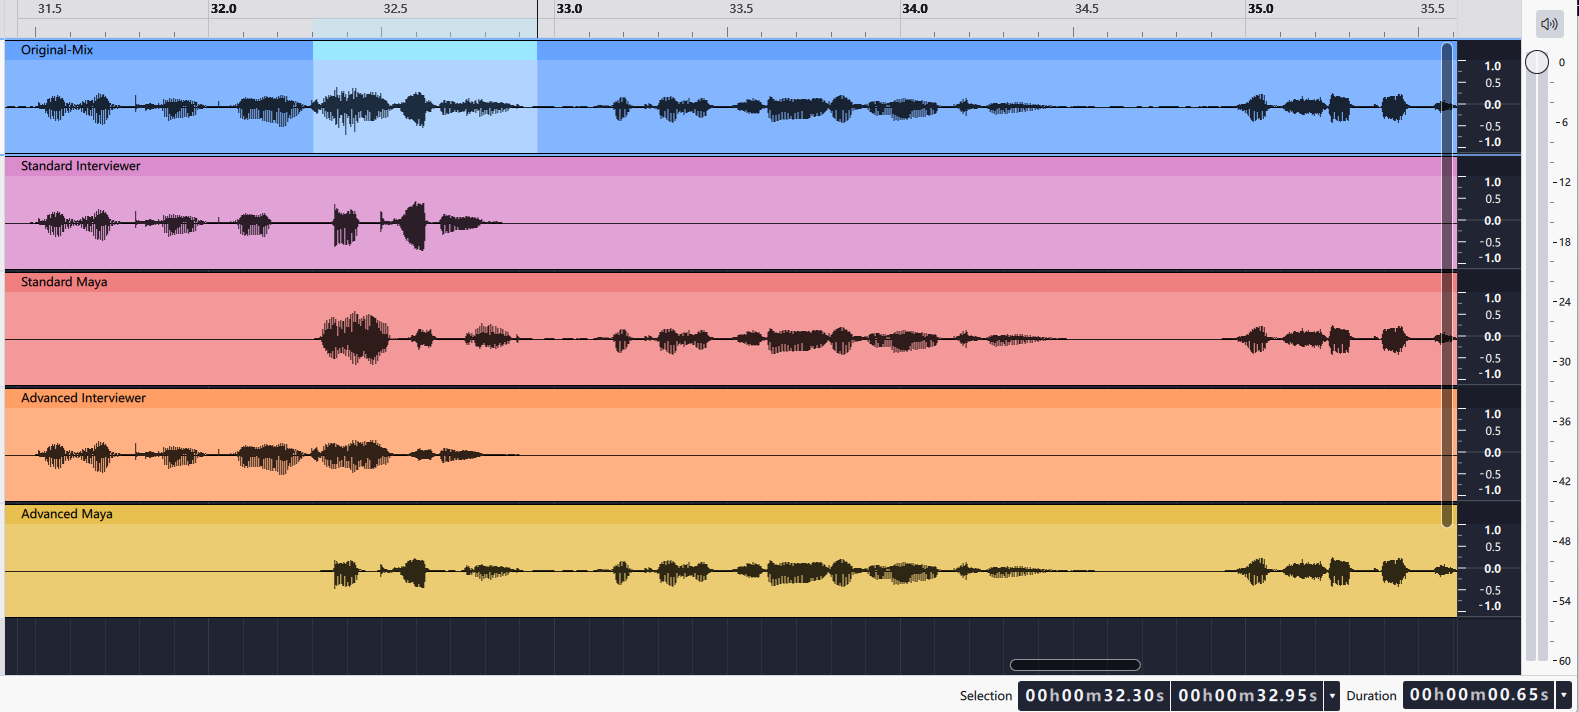
第一处同时说话位于 22.30–22.72 秒,持续 0.42 秒。我们的试听中,标准模式音轨里另一位说话人的残留形成了轻微、散开的嘶声感。我们将其视为同时说话导致的分离伪影,而非原始素材中的背景噪声。同一次试听中,高级模式没有明显可闻的噪声或串音。第二处同时说话位于 32.30–32.95 秒,持续 0.65 秒:标准模式存在可闻串音;高级模式的说话人归属更清楚,在所检查的片段中没有明显噪声或串音。
三步分别编辑采访者和嘉宾
- 选好源文件。 已有干净的独立麦克风轨道时,优先使用原始分轨;否则上传混合访谈或支持的视频文件。只处理拥有使用权限的素材。
- 分离并试听。 普通轮流发言可以先用标准模式;插话或同时说话可以考虑高级模式。高级模式自动检测人数,需要先完成一次购买。选择多个已知回答,对照原音确认哪条音轨属于嘉宾。
- 在编辑器中分别调整。 下载 WAV,将它们放在时间轴同一起点。播放分离音轨时,将原始混音静音,再调高较轻的人声、局部降低插话或移除不需要的问题。原始录音仍应保留,供随时对照。
可以只保留嘉宾的声音吗?
可以下载嘉宾的独立 WAV,或在编辑器中将采访者轨道静音。单人声音提取指南介绍了如何找到正确音轨、下载,以及检查停顿和残留串音。将采访者静音,并不能保证嘉宾音轨中也完全没有采访者的声音。
不同类型访谈的编辑重点
- 新闻采访: 保留原意和上下文。处理后的某个词听不确定时,引用前应核对原音,或向受访者确认。
- 纪录片: 可借助分离改善混音,同时保留有助于还原场景的环境声和自然反应。
- 用户研究: 分离便于降低主持人的提示音量;用于分析时,带说话人日志的转写通常更方便。
- 口述历史: 将未经修改的原始录音作为档案,分离音轨作为便于使用的副本。
- YouTube 访谈: 将 WAV 与原视频对齐,完成对话剪辑后再做最终响度处理。
需要提前考虑的失败情况
如果主要问题是插话,请参考多人同时说话指南中的定位与对比方法。完整设置和检查步骤见如何分离同一录音中的不同说话人。
如果最终需要的是文字
音轨适合剪辑;研究者和撰稿人可能更需要可检索文字、说话人标签、时间戳和字幕。这种情况下,可以使用访谈转写流程,也可以用同一份获授权录音分别运行两种工具。
格式与限制
- 支持的输入格式
- 标准模式:WAV, MP3, M4A, AAC, FLAC, MP4, MOV.
高级模式: WAV, MP3, M4A, AAC, FLAC, MP4, MOV。MP4 和 MOV 内必须是 AAC 或 PCM 音频。 - 输出
- 每位检测到的说话人各一条时间对齐的 WAV 音轨
- 上传限制
- 文件不超过 1 GB;高级模式时长不超过 90 分钟
- 计费步长
- 标准模式:每开始 1 分钟使用 10 积分,最低 10 积分。高级模式:每开始 1 分钟使用 60 积分,最低 60 积分。
计费前,服务端会将计算出的时长四舍五入到整秒。 处理前请核对积分预估。高级模式需要先完成一次购买;试用积分可用于标准模式。
私密处理
上传文件和结果仅对登录账户开放。
结果可访问 30 天
已完成任务的原始媒体和结果私密保存 30 天,提前删除则结束访问。
安全交付结果
完成后的文件会通过你的登录账户私密提供,供你试听和下载。
只上传你拥有或已获得处理授权的录音。