同一份音频中的两个人声可以尝试分开。将对话上传至 Seply,选择分离模式,再分别试听并下载每位说话人的 WAV 音轨。 音轨保留原始时间位置,便于之后一起编辑。效果取决于录音本身,尤其是两人同时讲话的情况。
本指南适用于用一支麦克风录制,或已经合并为一个文件的口语对话。分离歌曲中的歌手或乐器属于另一类任务。
操作顺序: 上传混合录音 → 选择标准模式和说话人数 → 试听并下载两条 WAV。可以按步骤操作,也可以先听标准模式示例。
三步分离两个人的声音
1. 上传录音
打开说话人分离工作区,登录后选择 MP3、WAV、M4A 等音频文件,也可使用支持的视频格式。尽量使用原始录音,并确认你拥有素材或已获得处理权限。
不需要先把单声道文件拆成左右声道。两个人的声音已经混在一起时,把它复制到两个声道并不能分离说话人。
2. 选择模式并核对积分预估
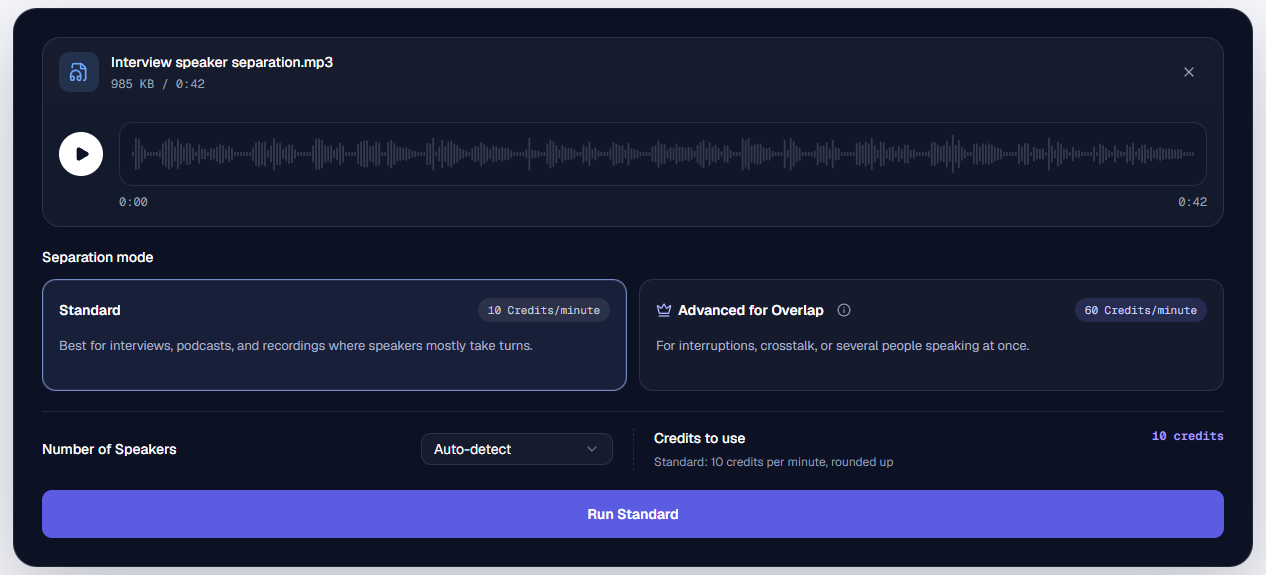
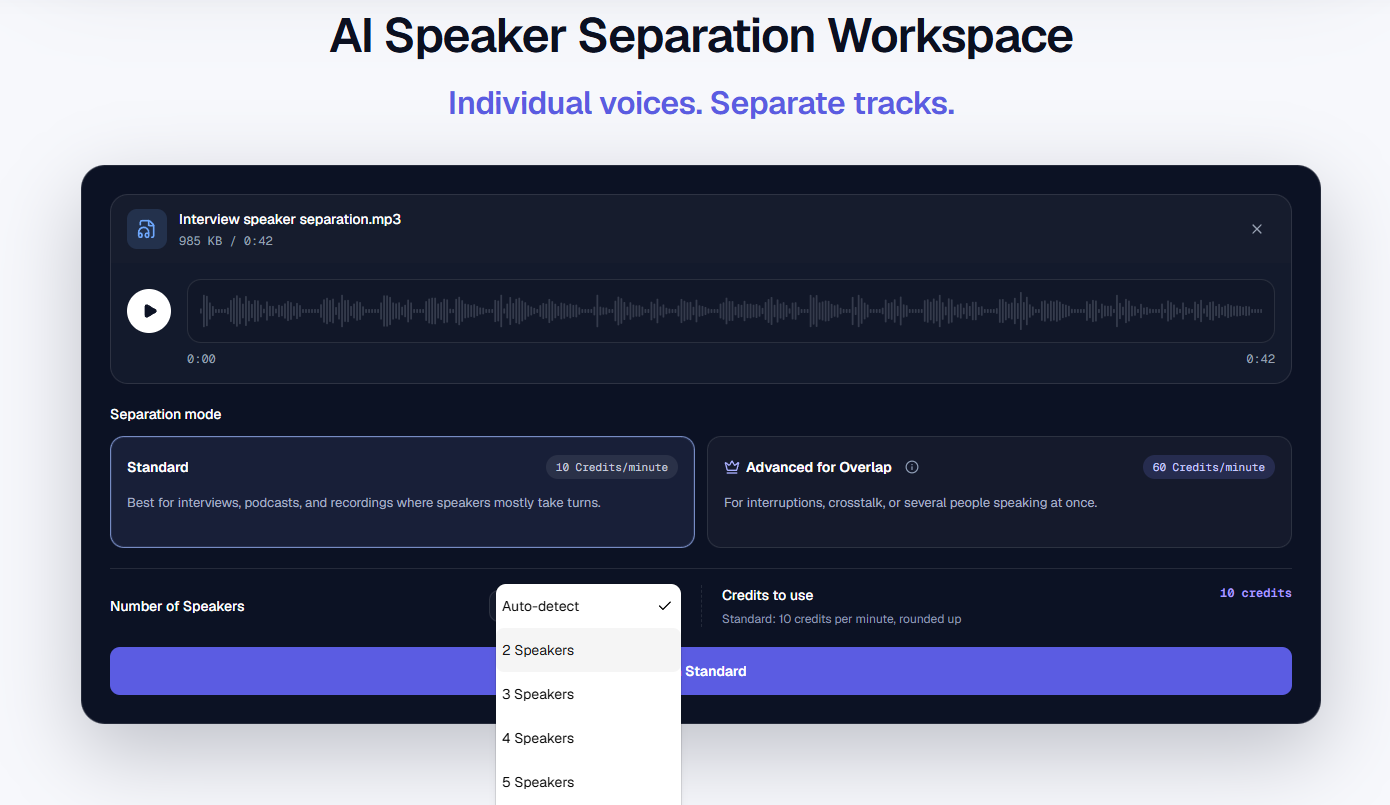
主要是轮流说话时,选择标准模式。在“说话人数”中,已知两人参与可选择 2 位说话人,也可保留“自动检测”。查看“预计使用积分”,再点击“运行标准模式”。
 查看原图 ↗
真实工作区的英文截图:Standard 为标准模式,Auto-detect 为自动检测。0:42 的录音预计使用 10 积分。核对后点击 Run Standard 开始分离。
在哪里选择两位说话人?
 查看原图 ↗
打开 Number of Speakers(说话人数),选择 2 Speakers 即可指定两人。截图中的勾仍在 Auto-detect 旁,并不表示已手动选定人数。
多人插话或同时讲话时,可使用高级模式。它会自动检测人数,需要先完成一次购买,积分费率也更高,请在开始前核对预估。实际对比见多人同时说话的处理指南。
3. 分别试听并下载 WAV
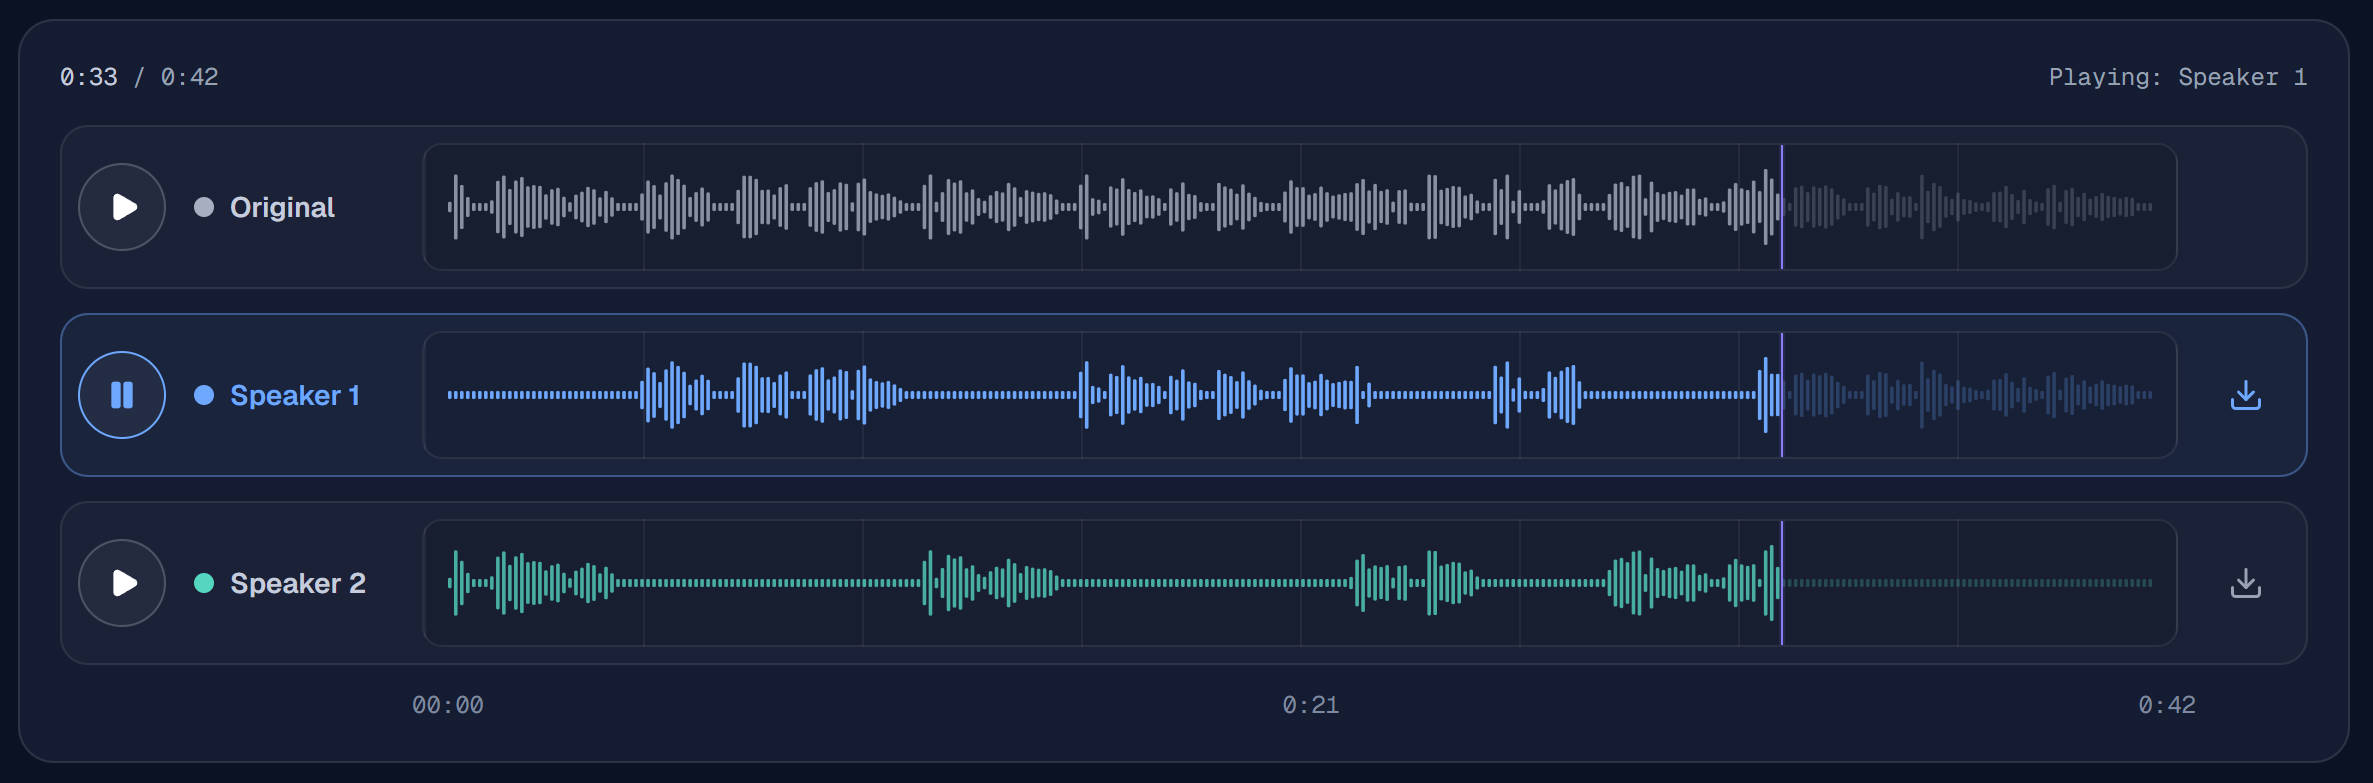
处理完成后,先播放“原始音频”,再听“说话人 1”和“说话人 2”。在开头、中间和结尾各检查几处,确认每条音轨属于谁,并重点听插话位置。编号只是本次任务的标签,不代表经过验证的真实身份,不同录音中的顺序也不一定相同。
 查看原图 ↗
真实结果的英文界面:当前在 0:33 选中 Speaker 1。左侧用于试听,右侧下载箭头用于保存该说话人的 WAV。请先听两条音轨,再判断各自对应哪位参与者。
需要双轨剪辑时,下载两条说话人 WAV。每个文件都保留原始时间位置,包括该说话人未发言时的停顿。输入 MP3 也会输出 WAV。如果只需要一方的声音,请查看单人声音提取指南。
试听一份混音与两条标准模式音轨
这里使用一段 42 秒原创对话,由有授权的 TTS 配音;标准模式输出为 2026 年 9 月 6 日实际处理所得。这是合成演示,不是客户录音。下方是已有的访谈测试文件,并非为这些截图重新运行的任务。
在同一位置切换“原始混音”“标准模式 — 采访者”和“标准模式 — Maya”,然后通过各行下载按钮保存 WAV。人物名称是编辑团队依据已知对话添加的标签,不能据此判断其他任务里哪条编号音轨属于谁。
两个文件都保留原始时间轴。波形平坦的区间可能只是另一人在说话,并非导出缩短。也请检查插话:这个标准模式示例仍有部分串音。处理条件与试听观察见访谈测试及来源说明。一段短示例不能预测所有对话的效果。
独立音轨可以用来做什么
在编辑器中,将 WAV 放到同一个时间轴起点。播放分离音轨时,将原始混音静音,避免两份声音同时播放;仍应保留原音供对照。
开始前的常见问题
可以上传同时包含两个人声的单个 WAV 或 MP3 吗?
可以。说话人分离就是从混合对话中分开声音。MP3 和 WAV 均受支持,压缩较少的原始文件可能保留更多细节。即使输入是 MP3,输出仍为 WAV。
如果录音里不止两个人呢?
可以使用自动检测,或在标准模式中指定已知人数,最多 10 人。每条输出都需要检查,短暂加入的嘉宾或相似声音可能被分配到错误音轨。
可以免费试用吗?
新账户会获得一次性 20 积分,有效期 30 天。积分在受支持的功能间共用,用于转写后,可供分离的余额会相应减少。高级模式不包含在标准模式试用中。当前费率、计费步长和文件限制见下方,处理前应以本文件预估为准。
之后还能下载音轨吗?
可以。在私密结果的 30 天访问期内,从历史记录重新打开已完成任务即可;提前删除的任务除外。请在到期前保存 WAV 文件。
只需要带说话人标签的文字稿怎么办?
使用语音转文字,得到文字而非独立音轨。普通的带标签转写不需要先分离音频。对比指南介绍了两类输出的区别。
如果声音没有分干净
强回声、响亮的音乐、削波、相似音色或持续同时说话,可能让一人的声音残留在另一条轨道。请把问题片段与原音对比;有较早、处理较少的源文件时可尝试使用。主要问题是同时讲话时,参考重叠语音指南。
格式与限制
- 支持的输入格式
- 标准模式:WAV, MP3, M4A, AAC, FLAC, MP4, MOV.
高级模式: WAV, MP3, M4A, AAC, FLAC, MP4, MOV。MP4 和 MOV 内必须是 AAC 或 PCM 音频。 - 输出
- 每位检测到的说话人各一条时间对齐的 WAV 音轨
- 上传限制
- 文件不超过 1 GB;高级模式时长不超过 90 分钟
- 计费步长
- 标准模式:每开始 1 分钟使用 10 积分,最低 10 积分。高级模式:每开始 1 分钟使用 60 积分,最低 60 积分。
计费前,服务端会将计算出的时长四舍五入到整秒。 处理前请核对积分预估。高级模式需要先完成一次购买;试用积分可用于标准模式。
私密处理
上传文件和结果仅对登录账户开放。
结果可访问 30 天
已完成任务的原始媒体和结果私密保存 30 天,提前删除则结束访问。
安全交付结果
完成后的文件会通过你的登录账户私密提供,供你试听和下载。
只上传你拥有或已获得处理授权的录音。