要分离同时说话的两个人声,可以把录音上传到 Seply,选择高级模式,再试听每位说话人的音轨。下载需要的 WAV 文件后,放进编辑器分别调整。
你刚开始追问,嘉宾也开始回答,两个人的声音混在同一份录音中;降低插话音量,回答也跟着变轻。说话人分离能增加调整空间,但即使使用高级模式,也可能残留另一人的声音。
先打开说话人分离工具,再按下面的步骤操作。
本页导航:操作步骤 · 试听结果 · 模式选择 · 进一步对比。
分离同时说话的五个步骤
1. 确认手中有哪些录音
如果每个人本来就有独立麦克风轨道,先听原始分轨,可能只需要在编辑器里调整音量。如果两人的声音混在一个文件中,又存在同时说话的情况,再考虑分离。
重点处理真正影响内容的位置。轻声笑一下或简短附和可能很自然;盖住关键回答的插话,更值得优先处理。
2. 准备并上传录音
尽量使用最清楚的原始文件,最好是尚未经过强降噪或其他清理的版本。打开 Seply,登录后选择音频或支持的视频文件,并确认文件名无误。
想先做短片段试验,可以在外部编辑器中裁出一段。保留同时说话前后的单人语音,便于辨认人物和对比音色,并记下片段在原录音中的起点。Seply 不负责这一步裁剪。
3. 选择高级模式并核对预估
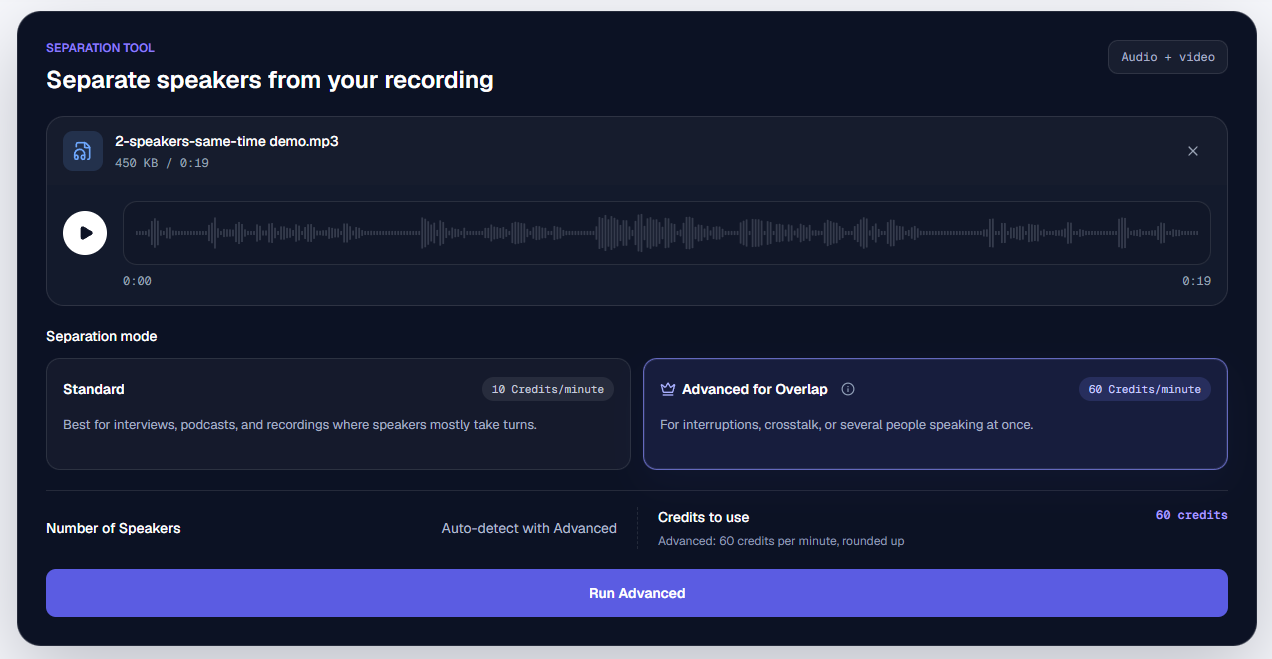
多人同时说话时,选择高级模式;英文截图中对应 Advanced for Overlap。系统会自动检测说话人,不需要输入姓名或上传声音样本。
开始前核对显示时长和预计积分。高级模式需要先完成一次购买,并有足够余额支付本任务。下方模式与费用对比介绍费率及标准模式试用,价格页面列出购买选项。确认录音与模式正确后,再启动处理。
 查看原图 ↗
英文界面中的 Advanced for Overlap 为高级模式,Credits to use 为预计积分,Run Advanced 为开始高级模式处理。此短录音按最低 60 积分预估,点击图片可查看大图。
4. 分别试听并下载音轨
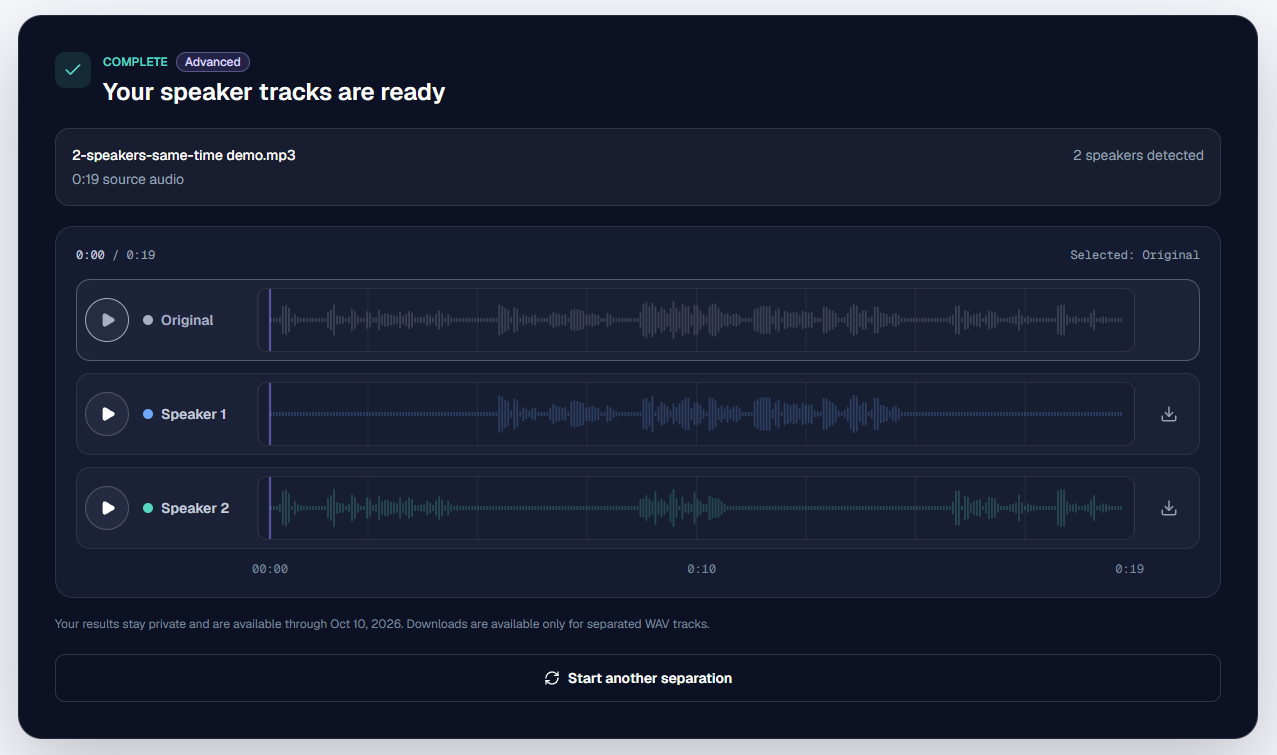
先听双方同时说话处的原音,再在同一时刻切换各条输出。确认每条音轨属于谁、需要的文字是否完整,也听听附近的单人片段作音色对比。
下载需要的 WAV。如果某个词似乎消失了,先检查其他输出,不要急着丢弃。音轨保留录音时间位置,因此一个人不说话时出现静音空隙是正常的。
 查看原图 ↗
处理完成后,依次试听 Original(原音)、Speaker 1 和 Speaker 2(说话人 1 和 2)。点击对应音轨旁的下载图标保存 WAV。图为英文界面,点击可查看大图。
5. 将音轨放入编辑器
将 WAV 导入音频或视频编辑器。处理整段录音时,与原文件放在同一起点;如果处理的是裁剪片段,将所有输出放回第二步记下的原始位置。
播放分离音轨时,先把原始混音静音,避免两份声音叠加。单独调节某人的音量或修改一次插话,再放回整段对话中听。这些编辑在外部编辑器完成,Seply 提供的是分离音频。
试听同时说话时的区别
第一组示例是一段 19.20 秒的 TTS 合成对话,分别用两种模式处理。先听原音,再在同一位置切换四条输出。
试听两种模式如何处理同时说话。
19.20 秒 TTS 合成对话 · 两位说话人 · Seply 原始输出
从第 8 秒听到第 11 秒,这时两人同时说话。在本示例中,标准模式输出带有嘶声感,音色也有明显变化;高级模式输出较干净,与附近单人语音相比没有明显音色变化。如果主要难点是多人同时讲话,我们建议优先考虑高级模式。
这些是 Seply 对这段素材的试听观察。下方第二组示例使用另一段对话,展示仍需要检查的问题。
结果还不理想时,接下来怎么做
| 听到的问题 | 可以尝试的处理 |
|---|---|
| 仍能听见另一人 | 分别听单轨与最终混音,判断残留是否影响使用。局部调音量可能有帮助,但把某段静音,也会移除该轨道此时需要保留的语音。 |
| 某个词丢失或出现在错误音轨 | 对照该时刻的原音和所有输出。仍听不清时,优先寻找其他麦克风录音或备用素材。 |
| 同时说话时音色变薄、带嘶声或发生变化 | 有更清楚、处理较少的源文件时,尝试换源。反复强力清理可能进一步改变目标人声。 |
| 声音重叠播放或不同步 | 将原始混音静音,核对各 WAV 的起点。裁剪片段应放回原时间位置,不是整段录音开头。 |
标准模式和高级模式,该选哪一个?
根据需要编辑的对话选择:主要轮流发言时,可以先用标准模式;主要问题是同时说话时,我们建议高级模式。 这里对比的是 Seply 的两种模式,不是不同服务商。
| 对比项目 | 标准模式 | 高级模式 |
|---|---|---|
| 适合的情况 | 以轮流发言为主 | 主要难点是多人同时说话 |
| 处理费用 | 每开始 1 分钟使用 10 积分;最低 10 积分 | 每开始 1 分钟使用 60 积分;最低 60 积分 |
| 试用与使用条件 | 20 积分最多处理约 2 分钟 | 需要先完成一次购买,并至少有 60 可用积分;只有 20 积分试用额度无法运行 |
| 说话人数 | 自动检测,或指定 2–10 位说话人 | 自动检测 |
计费依据服务端测得的时长,先四舍五入到整秒,再按分钟步长计算。开始前应核对预估。两种模式都提供时间对齐的 WAV,但不会替你完成音视频剪辑。
长录音可以先在外部编辑器里选取有代表性的片段,包含难处理的同时说话和附近单人语音。确认效果符合需求,再处理整份文件。
进一步对比:哪些差异仍然存在
第二组使用另一段 21.76 秒的 TTS 对话,下方附有参考原文。它说明了为什么即使选用高级模式,也值得逐词检查。
高级模式在某些情况下仍会留下另一人的微弱声音。本例中,它在同时说话处听起来更干净,但并非完美分离。
同一段录音,两种模式:对比同时说话部分。
21.76 秒 TTS 合成对话 · 两位男性说话人 · Seply 原始输出
在同一时刻切换音轨。整体而言,高级模式在本示例的同时说话处更干净,音色也更稳定。两种模式都不是完美的,高级模式仍有微弱串音。文件按原有音量播放,未额外清理。
对照参考原文试听
下方八句只对应第二组示例。说话人 1 和 2 与音频标签一致;同时说话标记表示哪两句存在交叠,不代表整句的完整时间范围。英文为生成示例的原文,中文仅供理解,不是自动识别结果。
| 说话人 | 英文原文与中文释义 | 片段 |
|---|---|---|
| 说话人 1 | The best part of that trip was the little cabin. 中文释义:那次旅行最棒的,就是住进那间小木屋。 | 同时说话 1 |
| 说话人 2 | Wait, you're forgetting the hike up to the lake! 中文释义:等等,你怎么把徒步去湖边的那段忘了! | 同时说话 1 |
| 说话人 1 | That's true. We got lost twice before we found it. 中文释义:说得也是。找到湖之前,我们迷了两次路。 | 单独发言 |
| 说话人 2 | And you kept saying you knew a shortcut. 中文释义:而且你一路都在说,你知道一条近路。 | 单独发言 |
| 说话人 1 | I still think my route had the better view. 中文释义:我还是觉得,我选的那条路风景更好。 | 同时说话 2 |
| 说话人 2 | Your shortcut added three extra miles to the walk! 中文释义:走你那条近路,我们多走了整整三英里! | 同时说话 2 |
| 说话人 1 | Okay, next time you can navigate. 中文释义:好吧,下次你来带路。 | 单独发言 |
| 说话人 2 | Deal. And you're carrying the snacks. 中文释义:成交。零食也归你背。 | 单独发言 |
重点听哪些地方
| 第二组示例的位置 | Seply 的试听观察 | 核对方法 |
|---|---|---|
| 0.65–2.70 秒 | 标准模式将说话人 2 的“Wait”分到了说话人 1 的音轨。 | 先听原音,再点击“试听标准模式说话人 1 中的 Wait”。 |
| 11.38–14.05 秒 | 标准模式在同时说话处带有嘶声感和音色变化;高级模式更干净,更接近附近的单人语音。 | 从“同时说话 2”开始,在四条输出间切换,并与单人片段比较。 |
| 11.38–11.96 秒 | 高级模式说话人 2 的音轨中,仍隐约可闻说话人 1。 | 点击“试听高级模式说话人 2 中的残留人声”,留意较轻的声音。 |
一个词出现在错误音轨上,是说话人归属错误;微弱的第二个人声是残留串音,也称声音泄漏;嘶声感和音色改变则是分离伪影的例子。实际要判断的是:你需要的文字和声音是否适合本次剪辑。
单独使用某人的声音时,既要戴耳机听单轨,也要检查最终混音。在完整对话里不突出的残留,单人片段中可能很明显。请保留原音,剪辑或引用前核对不确定的词。
关于这些示例
- 来源与方法: 两组都是提供的 TTS 合成对话,分别用 Seply 标准模式和高级模式处理。它们不是客户访谈。第二组附有生成时使用的参考原文,不是自动转写结果。
- 文件检查: 第一组有五个 19.20 秒文件;第二组有五个 21.76 秒文件。均为 44.1 kHz。两组中的 MP3 混音和高级模式 WAV 均为立体声,标准模式 WAV 为单声道。
- 播放文件: 本页没有再做清理、响度归一化或转码。音量或声道数不同,本身不能证明分离更好。波形经过缩放便于定位,不用于衡量质量。
- 试听观察: 说明来自 Seply 自己提供的观察,不是独立基准测试或客观准确率评分。页面更新日期是编辑日期,不代表音频处理日期。
- 适用边界: 两个短合成示例不能代表所有真实录音。相似声音、长时间同时讲话、回声、削波或音乐都可能改变结果;两组示例均不构成完美分离保证。
常见问题
可以免费分离同时说话的人声吗?
本页两组示例可以免费试听。20 积分最多用于约 2 分钟的标准模式处理。用高级模式处理自己的录音,需要先完成一次购买,并至少有 60 可用积分;只有 20 积分试用额度不能运行高级模式。当前费率见上方模式表。
降噪能去掉另一个人的声音吗?
降噪主要用于减少背景噪声。另一个人同时说的话也是语音,普通降噪不一定能分开两个人声。可以先通过说话人分离获得独立音轨,再判断是否需要进一步清理。
如果只想保留一个人的声音呢?
先分离对话,再试听找到目标人物,下载对应音轨。单人声音提取指南说明了如何确认人物和处理静音空隙。
会同时得到文字稿或剪辑好的视频吗?
这个流程输出的是音轨,不会完成视频剪辑,也不会自动生成文字稿。需要带说话人标签的文字时,请使用独立的语音转文字工具,并仔细核对同时说话部分的文字。
格式与限制
- 支持的输入格式
- 标准模式:WAV, MP3, M4A, AAC, FLAC, MP4, MOV.
高级模式: WAV, MP3, M4A, AAC, FLAC, MP4, MOV。MP4 和 MOV 内必须是 AAC 或 PCM 音频。 - 输出
- 每位检测到的说话人各一条时间对齐的 WAV 音轨
- 上传限制
- 文件不超过 1 GB;高级模式时长不超过 90 分钟
主要轮流发言时,请参考两人录音分离指南;采访者和嘉宾的编辑方法见访谈流程。
用自己的录音试试这些步骤:上传原文件、选择模式,核对积分预估后再开始。