要从录音中只保留一个人的声音,先将对话分成各说话人的独立音轨,试听找到目标人物,再只下载这个人的 WAV 文件。 WAV 会保留原始时间位置,包括这个人没有说话时的停顿。
这个流程适合保留访谈嘉宾的回答,或多人对话中自己的发言,不用于分离歌曲中的两位歌手。
操作顺序: 分离说话人 → 用两三个已知片段确认声音 → 下载对应音轨。可以从第一步开始,也可以直接查看下载示例。
先听原始对话,再找出要保留的声音
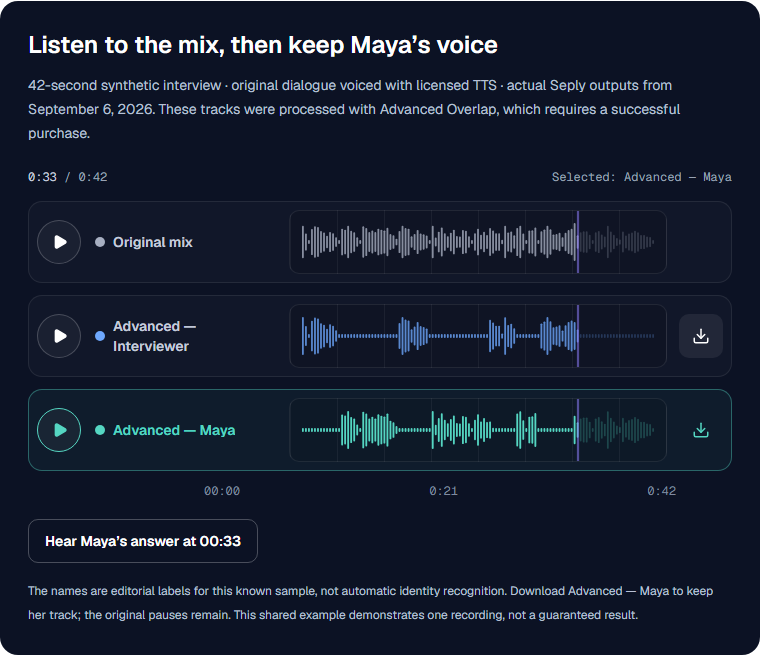
42 秒合成访谈 · 原创对话使用有授权的 TTS 配音 · Seply 于 2026 年 9 月 6 日实际处理所得。这些音轨使用高级模式处理;该模式需要先完成一次购买。
姓名是编辑团队为已知示例添加的标签,不是自动身份识别。下载“高级模式 — Maya”可保留她的音轨,原始停顿仍在。 本公开示例只展示一段录音,不保证其他素材也有相同效果。
这里要保留的是嘉宾 Maya。对比“原始混音”和“高级模式 — Maya”,或点击“试听 Maya 在 00:33 的回答”定位到结尾。相同原音和未经修改的输出文件,其来源与处理条件见访谈试听案例。这不是客户录音。
本页示例中,在哪里下载 Maya 的音轨?
 查看原图 ↗
2026 年 9 月 8 日截取的英文页面:Advanced — Maya 对应“高级模式 — Maya”,其右侧可下载 WAV。图中是上方公开试听示例,不是登录后的任务结果。
1. 分离对话中的说话人
打开说话人分离工作区,登录并上传拥有使用权或已获授权的录音。如果主要是轮流发言,可先选标准模式,设置已知人数或使用自动检测。
多人同时说话时,可以考虑高级模式,由系统自动检测说话人。处理前请确认模式和积分预估。文末的格式与限制中列有计费和购买要求。
完整设置流程见如何分离同一录音中的两个人声。本文重点介绍拿到音轨后如何操作。
2. 确认哪条音轨属于目标人物
不要默认说话人 1就是你要找的人。任务中的编号音轨,可能与本文示例里按姓名标记的音轨顺序不同。
选择两三个你已经知道此人在说什么的位置。访谈中可以选开场自我介绍、中间一段清楚的回答和结尾发言。逐一对比原音与候选音轨,确认整条音轨里始终是同一个人。
在本页示例中,可以用 Maya 在 00:33 之后的回答作一次检查,再核对前面的一段回答。如果某个词似乎缺失,下载前也听一下另一条音轨。
3. 只下载目标音轨
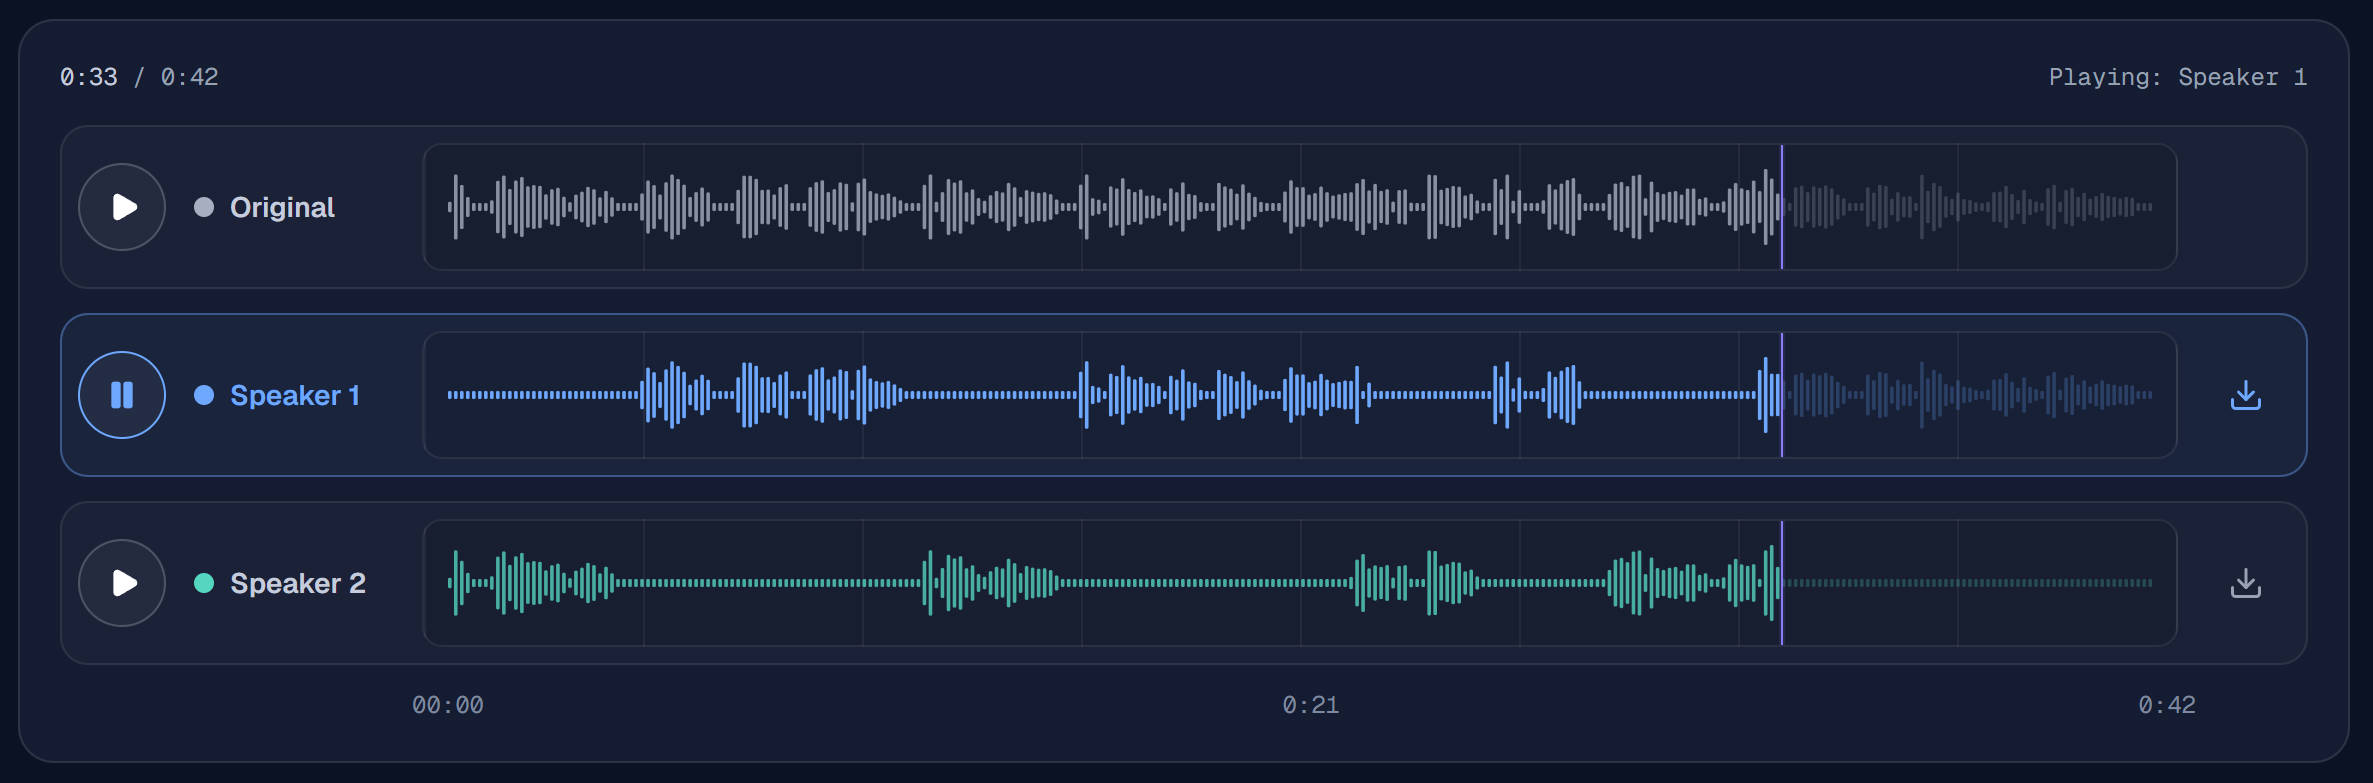
确认声音后,点击该说话人所在行右侧的下载箭头。左侧是播放按钮。不需要下载所有人的音轨。
 查看原图 ↗
真实任务的英文界面截图:在 0:42 录音的 0:33 处选中 Speaker 1。若已试听确认这就是目标声音,可点击同一蓝色行的下载箭头,只保存该 WAV。截图使用编号标签,不能据此判断具体人物,也没有展示所用处理模式。
即使上传的是 MP3,下载仍为 WAV。在结果的 30 天访问期内,可以从历史记录重新打开已完成任务。
为什么下载的音轨里仍有静音
举个时间轴示例:采访者在 00:00–00:04 说话,嘉宾从 00:04 开始回答。嘉宾的 WAV 会保留前四秒的位置,因此文件开头可能是静音,回答仍从 00:04 开始。这只是时间关系的示意,不是对上方素材的测量,也不保证空隙完全无声。
- 用于视频时: 把 WAV 放在与原录音相同的起点,保留停顿,使声音继续与画面对齐。
- 制作短音频时: 下载后可在外部编辑器中裁掉不需要的停顿。Seply 不会在导出单条音轨时自动移除这些空隙。
4. 检查双方同时说话的位置
下载一位说话人的音轨,也不等于保留全部原始背景声。分离可能改变音乐、房间声和偶发声音。如果这些声音对最终剪辑很重要,应在编辑器中核对完整混音,不要假设说话人音轨会原样保留它们。
长时间同时说话的处理方法见如何分离同时说话的两个人声。
常见问题
可以移除采访者,只保留嘉宾吗?
只导出嘉宾时,下载按前述步骤确认的音轨即可。如果双方发言都要保留一部分,把两条 WAV 导入编辑器,再按需降低采访者音量。具体参考访谈剪辑流程。
可以从多人录音中提取自己的声音吗?
可以,流程相同。标准模式支持自动检测,或手动设置最多 10 位说话人;高级模式自动检测人数。极短发言和相似音色可能使连续一致的音轨更难确认。
上传前可以指定要提取谁吗?
不可以。Seply 不会使用姓名、照片或参考声音样本提前锁定某个人。处理后,需要通过试听选择对应音轨。
只保留一个人的声音免费吗?
选择和下载已完成的音轨,不会改变处理费率。新账户可获得一次性 20 积分,有效期 30 天,最多用于约 2 分钟的标准模式处理。本文公开示例无需登录或处理自己的录音,即可试听和下载。
格式与限制
- 支持的输入格式
- 标准模式:WAV, MP3, M4A, AAC, FLAC, MP4, MOV.
高级模式: WAV, MP3, M4A, AAC, FLAC, MP4, MOV。MP4 和 MOV 内必须是 AAC 或 PCM 音频。 - 输出
- 每位检测到的说话人各一条时间对齐的 WAV 音轨
- 上传限制
- 文件不超过 1 GB;高级模式时长不超过 90 分钟
- 计费步长
- 标准模式:每开始 1 分钟使用 10 积分,最低 10 积分。高级模式:每开始 1 分钟使用 60 积分,最低 60 积分。
计费前,服务端会将计算出的时长四舍五入到整秒。 处理前请核对积分预估。高级模式需要先完成一次购买;试用积分可用于标准模式。